
0.5.0
pyqpanda3 0.5.0 是性能版本。最核心的变化包括:全系列 CPU 模拟器支持精度选择(每个模拟器都接受 precision="float32" 或 "float64")、可移植的 SIMD 分派器在运行时加速态矢量内核,以及重写的 LightSABRE 布局/路由引擎使转译更快且输出质量可度量地更好。此外,0.5.0 还新增了原生 RESET 操作、模拟器能力注册表、带运行统计的 MPS 截断控制、显式约定的噪声模型语义,以及随平台专属 wheel 一起分发的 mimalloc 分配器。
1. 模拟器精度选择
所有 CPU 系列模拟器在构造时接受 precision 关键字。float32 将状态的内存占用减半,并在支持 SIMD 的主机上使内核吞吐大致翻倍;float64 仍为默认精度以保证完整精度。该选择在每个实例上不可变,可通过 precision 属性读回,同时可读的还有 supported_precisions。
import numpy as np
from pyqpanda3.core import CPUQVM, MPSQVM, H, CNOT, QProg

seed = np.array([0.5, 0.5, 0.5, 0.5], dtype=np.complex64)
prog = QProg() << H(0) << CNOT(0, 1)

qvm32 = CPUQVM(precision="float32")
qvm32.init_state(seed)
state32 = qvm32.current_state()
print(state32.dtype, qvm32.precision, tuple(qvm32.supported_precisions))

qvm64 = CPUQVM()  # 默认:float64
qvm64.init_state(seed)
print(qvm64.current_state().dtype, qvm64.precision)

mps = MPSQVM(precision="float32")
mps.run(prog, 2)
print(mps.current_state().dtype, mps.current_state().shape)
运行结果:
complex64 float32 ('float32', 'float64')
complex128 float64
complex64 (4,)
current_state() 是 CPUQVM 与 MPSQVM 的新方法:以 NumPy 数组返回状态,dtype 与模拟器原生精度一致(float32 对应 complex64,float64 对应 complex128)。两者所反映的状态不同,这一区别至关重要:CPUQVM.current_state() 镜像的是 init_state(...) 最近装入的状态,不会被 run() 填充(run() 产生的状态需经 result().get_state_vector() 读取);MPSQVM.current_state() 则由 run() 填充。DensityMatrixSimulator 新增了对应的 density_matrix_native()。
精度家族覆盖 CPUQVM、DensityMatrixSimulator、MPSQVM、PartialAmplitudeQVM、SingleAmplitudeQVM 与 SparseHeisenbergSimulator(各自支持 float32/float64)。Stabilizer 报告精确的 precision="exact" 并拒绝算术精度。构建启用 CUDA 时 GPUQVM 同时支持 float32 与 float64;未启用 CUDA 的构建仅注册 float64 并将该后端标记为不可用。需要注意,注册表的 available 标志描述的是 wheel 的构建方式,而非主机能否实际运行:在驱动版本低于随包分发 CUDA 运行时的主机上,启用 CUDA 的构建仍报告 available=True,并在构造时抛出 CUDA 运行时自身的 RuntimeError。
非法请求会尽早、清晰地失败:
from pyqpanda3.core import CPUQVM, Stabilizer

try:
    CPUQVM(precision="float16")
except ValueError as e:  # InvalidPrecisionError,ValueError 的子类
    print(type(e).__name__, "-", e)

try:
    Stabilizer(precision="float32")
except ValueError as e:  # UnsupportedPrecisionError
    print(type(e).__name__, "-", e)
运行结果:
InvalidPrecisionError - unknown precision 'float16'
UnsupportedPrecisionError - backend 'Stabilizer' does not support precision 'float32'; supported precisions are: exact新增异常类型:InvalidPrecisionError、UnsupportedPrecisionError、PrecisionConversionError(均为 ValueError 子类),以及构造构建缺失的模拟器时抛出的 BackendUnavailableError(RuntimeError 子类)。
2. 模拟器能力注册表
simulator_capabilities() 无需构造任何对象即可回答"这里能运行什么"。传入名称时返回一条 SimulatorCapabilities 记录;无参调用返回全部记录。
from pyqpanda3.core import simulator_capabilities

for cap in simulator_capabilities():
    print(f"{cap.name:26s} {','.join(cap.supported_precisions):16s}"
          f" default={cap.default_precision:8s} available={str(cap.available):5s}"
          f" domain={cap.simd_domain}")
运行结果:
CPUQVM                     float32,float64  default=float64  available=True  domain=StateVector
DensityMatrixSimulator     float32,float64  default=float64  available=True  domain=Density
GPUQVM                     float64          default=float64  available=False domain=NotApplicable
MPSQVM                     float32,float64  default=float64  available=True  domain=Tensor
PartialAmplitudeQVM        float32,float64  default=float64  available=True  domain=Amplitude
SingleAmplitudeQVM         float32,float64  default=float64  available=True  domain=Amplitude
SparseHeisenbergSimulator  float32,float64  default=float64  available=True  domain=Sparse
Stabilizer                 exact            default=exact    available=True  domain=NotApplicable
每条记录包含 name、supported_precisions、default_precision、available 与 simd_domain(取值为 StateVector、Density、Tensor、Amplitude、Sparse、NotApplicable 之一)。注册表内容是宿主相关的:在上例所用的无 CUDA 主机上,simulator_capabilities("GPUQVM").available 为 False,构造 GPUQVM 会抛出 BackendUnavailableError,而不是在导入时含糊地失败;在启用 CUDA 的构建上该行为 float32,float64。
3. SIMD 运行时分派
态矢量内核现在为多种 SIMD 指令集编译,并在进程启动时由运行时探测器选择——x86_64 主机在 scalar、sse2、avx2、avx512 之间选择;ARM64 主机在 scalar、neon、sve、sve2 之间选择。新的 pyqpanda3.core.simd 子模块暴露了诊断信息与偏好覆盖:
from pyqpanda3.core import simd

cap = simd.capabilities()
print(cap.architecture, list(cap.available_backends), cap.active_backend)

simd.set_preference("scalar")   # 强制标量内核
print(simd.active_backend())
simd.set_preference("auto")     # 恢复探测到的默认值
print(simd.active_backend())
运行结果(在支持 AVX2 的 x86_64 主机上):
x86_64 ['scalar', 'sse2', 'avx2', 'avx512'] avx2
scalar
avx2
simd.capabilities() 返回不可变快照,包含 architecture、compiled_backends、available_backends、default_backend、active_backend 与 fallback_reason。simd.set_preference(backend, strict=False) 对不可用后端不会抛异常(而是记录回退原因);strict=True 时抛出 UnsupportedSIMDBackendError。在发布基准主机上,AVX2 内核在代表性随机电路套件上相对标量的中位加速为 2.13x(float32 约 2.5x,float64 约 1.9x)。
4. MPS 截断控制与运行统计
MPSQVM 现在在构造时接受 truncation_atol 与 max_bond_dimension,并通过新的 stats() 方法报告 SVD 截断的实际行为(返回 MPSRunStats,含 discarded_weight 与 max_bond_dimension_seen)。
import numpy as np
from pyqpanda3.core import MPSQVM, QProg, RY, CZ

rng = np.random.default_rng(7)
prog = QProg()
for q in range(6):
    prog << RY(q, rng.uniform(0, np.pi))
for layer in range(4):
    pairs = [(0, 1), (2, 3), (4, 5)] if layer % 2 == 0 else [(1, 2), (3, 4)]
    for a, b in pairs:
        prog << CZ(a, b) << RY(a, rng.uniform(0, np.pi)) << RY(b, rng.uniform(0, np.pi))

capped = MPSQVM(precision="float64", max_bond_dimension=2)
capped.run(prog, 1)
print(capped.stats().discarded_weight, capped.stats().max_bond_dimension_seen)

exact = MPSQVM()
exact.run(prog, 1)
print(exact.stats().discarded_weight, exact.stats().max_bond_dimension_seen)
运行结果:
0.024353811677256556 2
1.8613363972962274e-34 4
默认 truncation_atol 依精度而定(float32 为 1e-6,float64 为 1e-12);max_bond_dimension 默认不限。SingleAmplitudeQVM 新增对应的 stats()(返回 SingleAmplitudeStats,含 cache_hit_count、cache_miss_count 与 peak_workspace_bytes)。
5. 原生 RESET 操作
RESET(qubit) 将量子比特坍缩到 |0>,是一个一等公民式的非幺正操作——用户代码不再需要 measure 加条件 X 的模拟写法。它恰好在 CPU 态矢量与密度矩阵模拟器上受支持;其他后端在执行时报错,受控 RESET 没有物理定义。
from pyqpanda3.core import CPUQVM, QProg, RESET, X, measure

prog = QProg() << X(0) << RESET(0) << measure(0, 0)
qvm = CPUQVM()
qvm.run(prog, 100)
print(qvm.result().get_counts())
运行结果:
{'0': 100}该操作可经 OriginIR 双向往返,并可将 OpenQASM 2.0 的 reset q[i]; 语句解析为原生门。注意一个边界:0.5.0 中用 convert_qprog_to_qasm() 将含 RESET 的程序导出回 OpenQASM 会抛出 RuntimeError——需要序列化含 RESET 的程序时请使用 OriginIR。
6. LightSABRE 转译引擎重写
布局与路由栈围绕共享的 LightSABRE 引擎重建:带均衡布局-路由目标函数的双向 SABRE 布局搜索、面向可子图嵌入电路的 VF2 匹配补全、环形邻域布局候选,以及限制病态实例上搜索量的工作量熔断器。Python 入口保持不变——RoutingMethod.LIGHT_SABRE、LayoutMethod 与 0.4.1 引入的 TranspilationOptions.execution 配置——但输出质量更好、编译时间显著降低。
在 benchpress 套件上(与 Qiskit 2.5.2 的 1,044 个配对测试用例,双方均 1,044/1,044 全部通过),pyqpanda3 0.5.0 在 1,044 例中的 1,040 例上快于 Qiskit,几何平均时间比为 0.233x,同时输出线路的双量子比特门总数保持略优(0.957x)。在 892 个抽象编译用例上几何平均为 0.212x,双量子比特深度合计为 Qiskit 的 0.918x。完整分析见基准测试页面。
确定性是契约的一部分:固定 TranspilationExecutionConfig.seed 后,同一程序的重复转译产生完全相同的输出,且该配置现在也可以作为位置参数版 transpile() 的最后一个位置参数传入:
from pyqpanda3.core import CNOT, H, QProg
from pyqpanda3.transpilation import Transpiler, TranspilationExecutionConfig, generate_topology

prog = QProg() << H(0) << CNOT(0, 1)
topo = generate_topology(4, "square")

config = TranspilationExecutionConfig()
config.seed = 42

transpiler = Transpiler()
a = transpiler.transpile(prog, topo, {}, 2, ["RX", "RY", "RZ", "CZ"], config)
b = transpiler.transpile(prog, topo, {}, 2, ["RX", "RY", "RZ", "CZ"], config)
print(len(a.operations()) == len(b.operations()))
运行结果:
True7. 噪声模型语义的显式约定
噪声模型约定现已明确写出而非留待推断:Kraus 算符矩阵为行主序、ReadoutError 矩阵按 M[true][measured] 索引、量子误差作用于其所附着指令之后、局部(按量子比特)误差覆盖默认误差而非与之复合。NoiseModel 也支持真正的拷贝语义:
import copy
from pyqpanda3.core import NoiseModel

model = NoiseModel()
model.add_read_out_error([[0.9, 0.1], [0.2, 0.8]], 0)

duplicate = copy.deepcopy(model)
snapshot = model.copy()
print(duplicate is not model, snapshot is not model)
运行结果:
True True8. 更快的内核,更小的 wheel
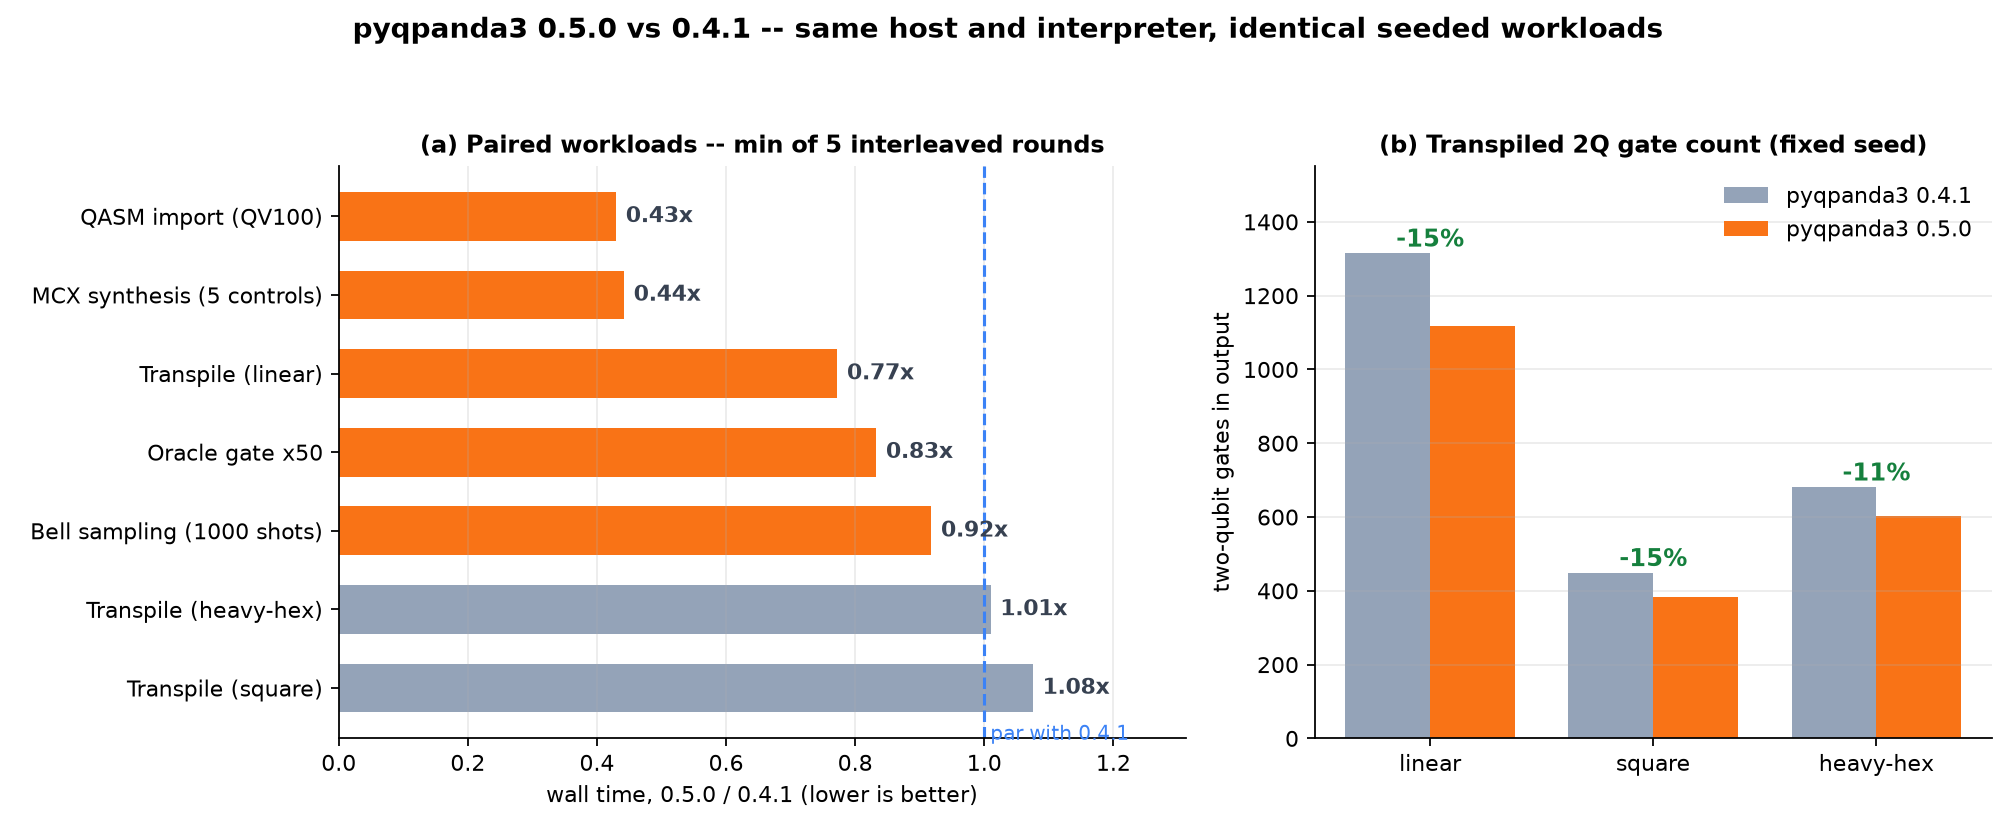
0.4.1 与 0.5.0 两个 wheel 也在同一主机、同一解释器上以相同的种子化负载做了正面对比(随机长程 19 比特线路 × 三种固定耦合图、QV100 规模 QASM 导入、5 控制 X 综合、4 比特酉 Oracle 循环;时间为五轮交叉运行的最小值)。内核级的收益直接可见:QASM 导入为 0.4.1 用时的 0.43x,MCX 综合为 0.44x 且输出完全相同的 248 个 CZ 门,线性拓扑转译为 0.77x;方形与 heavy-hex 拓扑的转译用时持平,而种子固定时转译产物的双量子比特门数分别下降 15% / 15% / 11%(线性 / 方形 / heavy-hex)。态矢量 float64 演化与 0.4.1 性能相当——模拟提速来自新的 float32 路径与 SIMD 内核(发布基准套件上 AVX2 相对标量中位 2.13x)。
- Oracle 内核:ORACLE(任意大矩阵)门模拟路径采用零拷贝矩阵处理、分块 GEMM 与手写 AVX2 复数 GEMV/GEMM 内核;修正了路由后线路的量子比特序语义(分解在布局重排后保持等价)。
- QASM 导入快速通道:导入 QV100 规模的 QASM 文件不再物化中间线路副本;QV100 导入基准从 1.48s 降至 0.73s。
- DAG 与翻译:DAG 线路构造引入移动语义与每节点扫描头缓存(配对套件上端到端转译约快 20%),常量折叠优化器按定点阈值收敛,抵消/星形扫描传递确定性去分配。
- mimalloc:wheel 捆绑 mimalloc 分配器作为私有共享运行时,Python 扩展经由其分配,使大规模状态的性能更稳定;wheel 现为平台专属(
cpXY-cpXY-<platform>标签),pip会按解释器与操作系统解析正确的二进制包。
API 变更
- 为
CPUQVM、DensityMatrixSimulator、MPSQVM、PartialAmplitudeQVM、SingleAmplitudeQVM、SparseHeisenbergSimulator与GPUQVM新增precision构造关键字及precision/supported_precisions属性;Stabilizer报告precision="exact"。 - 新增
pyqpanda3.core.simulator_capabilities(name=None)与SimulatorCapabilities记录类型(name、supported_precisions、default_precision、available、simd_domain)。 - 新增
pyqpanda3.core.simd子模块:simd.capabilities()、simd.active_backend()、simd.set_preference(backend, strict=False)与SIMDCapabilities快照类型。 - 新增异常
InvalidPrecisionError、UnsupportedPrecisionError、PrecisionConversionError(ValueError子类)与BackendUnavailableError、UnsupportedSIMDBackendError(RuntimeError子类)。 - 新增
CPUQVM.current_state()与MPSQVM.current_state(),返回原生精度numpy.ndarray状态。 - 新增
DensityMatrixSimulator.density_matrix_native(),返回模拟器原生 dtype 的密度矩阵。 - 新增
MPSQVM构造关键字truncation_atol与max_bond_dimension,以及MPSQVM.stats() -> MPSRunStats(discarded_weight、max_bond_dimension_seen)。 - 新增
SingleAmplitudeQVM.stats() -> SingleAmplitudeStats(cache_hit_count、cache_miss_count、peak_workspace_bytes)。 - 新增原生
RESET(qubit)门与GateType.RESET枚举值;OriginIR 可发射并解析它,QASM 可解析它;含 RESET 的 QASM 导出抛出RuntimeError(已知限制)。 Oracle(qubits, matrix, check_unitary=True)新增check_unitary关键字:在构造门之前校验矩阵,否则抛出ValueError。Oracle 矩阵按所给量子比特的顺序作用,qubits[0]为最高位因子。- 新增
NoiseModel.copy()、NoiseModel.__copy__、NoiseModel.__deepcopy__。 expval_pauli_operator()/expval_hamiltonian()接受init_state(态矢量)以跳过重复制备。Transpiler.transpile()位置参数重载现在接受execution_config作为最后一个位置参数(也可按关键字传入)。- 修复
QCloudOptions.get_custom_option():原来四个按类型的重载在 Python 侧坍缩为同一签名,导致只有int实例化可达;现在返回存储值的真实类型。int、float、str原样往返;Python 的bool会以int返回(True->1),因为bool是int的子类,绑定会解析到整数重载。 PartialAmplitudeQVM.get_state_vector()现在返回 NumPy 数组(dtype 随模拟器精度)。QCloudBackend.chip_info()省略 options 时不再抛TypeError。StabilizerResult.get_state_vector()现在抛出描述性RuntimeError,而不是静默返回空列表。convert_qasm_file_to_qprog()对缺失文件抛RuntimeError,而不是返回空程序。direct_twirl(input_circ, twirled_gate, seed)使低于 8000 的种子真正生效(此前会坍缩为相同结果)。- 噪声模型语义显式化:Kraus 行主序、
ReadoutError按M[true][measured]索引、噪声作用于指令之后、局部覆盖默认。 - QASM 导出多控制门使用紧凑恒等式(如 Toffoli 59 → 1 行、3 控制 Z 150 → 33 行),并修正导出算子的基于 CSD 的分解。
QProg.remap的默认remap_cbits={}不再丢失经典比特映射。- wheel 为平台专属(
cpXY-cpXY-<platform>标签)并捆绑 mimalloc 运行时;pyqpanda3._native_runtime在 Windows 上加载捆绑的 DLL 目录。