
Benchmark
该基准测试是基于 IBM 的 Qiskit benchpress。我们在其基础上为 pyqpanda3 添加了测试项,以完成相关测试。我们的测试代码可以在 https://github.com/OriginQ/benchpress 中找到。我们在文献《QPanda3: A High-Performance Software-Hardware Collaborative Framework for Large-Scale Quantum-Classical Computing Integration》中介绍了更详细的实验内容。本页引用了文章中的重要实验结果。
"Benchpress 开源基准测试套件包含 1,000 多项不同的测试。这些是由量子计算社区的其他成员设计的标准化基准测试。例如,Benchpress 比较 SDK 生成 QASMBench 线路、费曼线路和哈密顿线路的能力。它还包括测试 SDK 为特定硬件(例如 IBM 量子处理器的重六边形架构及其他通用量子比特布局)转译线路能力的测试。"
— IBM Qiskit
量子线路构造
多个量子计算 SDK 在线路构造方面的表现如图 Quantum Circuit Construct 所示。可以发现,QPanda3、qiskit 和 cirq 通过了全部 7 个测试用例。对于test_multi_control_circuit、test_bigint_qasm2_import、test_param_circSU2_100_build和test_clifford_build等4个测试用例,QPanda3的用时最少。对于测试用例test_QV100_qasm2_import、test_param_circSU2_100_build和test_QV100_build等3个测试用例,QPanda3用时多于qiskit,明显少于cirq、braket和bqskit。对于测试用例test_DTC100_set_build,QPanda3用时少于qiskit,多于cirq,是用时第二少的。该图显示了QPanda3在线路构造方面的优势。

操作
Benchpress 文献《Benchmarking the performance of quantum computing software》指出 Manipulate 是衡量 SDK 的一个重要指标。如下图 Manipulate 所示,只有 QPanda3 和 qiskit 通过了全部的 4 个测试用例。QPanda3在test_QV100_basis_change测试中,是用时最少的。对于test_random_clifford_decompose、test_multi_control_decompose和test_DTC100_twirling三个测试用例,QPanda3用时仅超过qiskit且与qiskit相差很小。该图表示,QPanda3在Manipulate指标上具有优势。

量子线路编译
在我们的实验中,只有 QPanda3 和 qiskit 通过了大部分关于编译的测试用例。我们将对应的实验结果绘制成了如图 Quantum Circuit Transpilation 所示的多张散点图,分别展示了对于不同的拓扑结构,QPanda3 和 qiskit 在 2Q Gate Count、2Q Gate Depth 和编译用时方面的差异。其中,各图中的蓝色虚线表示 QPanda3 和 qiskit 在对应指标下的数值是相等的。在蓝色虚线上方的点表示 QPanda3 对应的数值小于 Qiskit。
从图 Quantum Circuit Transpilation 可以发现,对于 2Q Gate Count 和 2Q Gate Depth,大部分散点密集地分布在蓝色虚线上或极其相近的位置,这说明 QPanda3 和 qiskit 的表现基本相同。然而,对于编译用时,图 Quantum Circuit Transpilation 中的四张子图中,散点全部分布在蓝色虚线上方,这说明 QPanda3 比 qiskit 具有更高的编译效率,而且这个特征不受拓扑结构的限制,同时对大量不同的线路均有效。同时,可以观察到,只有极个别测试用例使用 QPanda3 的用时会超过 10 秒。这些都说明 QPanda3 的编译效率十分高。

pyqpanda3 0.5.0 对比 Qiskit 2.5.2 —— benchpress 全量对比(2026 年 9 月)
测量配置
伴随 pyqpanda3 0.5.0 的发布,benchpress 完整套件在同一台服务器上与 Qiskit 2.5.2 重新进行了对比测试。两个 SDK 运行于同一台服务器、同一解释器与同一 benchpress 修订版本之上,因此每个用例均可一一配对,无需跨机器校准。测量配置如下:
| 项目 | 取值 |
|---|---|
| 主机 | Intel(R) Xeon(R) Gold 6226R CPU @ 2.90 GHz,64 核 |
| 解释器 | CPython 3.14.7 |
| 数值栈 | NumPy 2.5.3、SciPy 1.18.1 |
| 被测方 | pyqpanda3 0.5.0 —— benchpress 运行 0069_qpanda3(2026-09-21) |
| 参照方 | Qiskit 2.5.2(含 qiskit-ibm-runtime 0.49.0)—— benchpress 运行 0055_qiskit(2026-09-15) |
| 配对用例 | 1,044 |
| 套件状态 | 双方各自 1,044 通过、0 失败;双方各有 22 个参数化占位用例跳过 |
| 线路规模范围 | 1 至 930 个量子比特 |
双方的腿均通过了全部 1,044 个用例,因此不存在缺失用例,也没有任何结果为推断值。计时指标为配对用例的 pytest-benchmark stats.mean,直接取自测试框架自身产出的结果文件。
本节通篇并列报告两种比值统计量,二者回答的是不同问题:
- 逐用例比值的几何平均 描述典型用例,对每条线路等权;
- 平均用时求和之比 描述整体聚合,因而由最慢的线路主导。
只引用其中一种都可能在任一方向上产生误导,因此下文的分套件表格同时给出两者。
总体结果
在全套件上,pyqpanda3 0.5.0 在 1,044 个配对用例中的 1,040 例上用时更短,几何平均时间比为 0.233x,平均用时求和之比为 0.259x。按整轮累计,被测方耗时 2,708.3 秒,参照方耗时 5,191.2 秒——墙钟时间比为 0.522。
按编译目标划分,892 个抽象编译用例(不含设备耦合图)的几何平均为 0.212x,140 个设备定向用例为 0.400x。
分套件结果
| 套件 | 用例数 | 几何平均比 | 平均用时求和之比 | 更快的用例数 | 双比特门比 | 双比特深度比 |
|---|---|---|---|---|---|---|
| 抽象哈密顿量编译 | 400 | 0.303x | 0.234x | 399 | 0.834x | 0.783x |
| QASMBench small | 168 | 0.140x | 0.340x | 168 | 1.009x | 1.003x |
| QASMBench medium | 92 | 0.207x | 0.289x | 92 | 0.981x | 0.976x |
| QASMBench large | 232 | 0.157x | 0.259x | 232 | 0.985x | 0.942x |
| 设备哈密顿量编译 | 81 | 0.380x | 0.282x | 81 | 0.776x | 0.748x |
| Feynman | 50 | 0.452x | 0.320x | 50 | 1.013x | 1.006x |
| Summit 100Q | 9 | 0.329x | 0.200x | 9 | 1.049x | 1.100x |
| 线路操作 | 4 | 0.790x | 0.973x | 3 | — | — |
| 线路构造 | 8 | 0.400x | 0.468x | 6 | 1.000x | 1.000x |
| 全套件 | 1,044 | 0.233x | 0.259x | 1,040 | 0.957x | 0.915x |
由此可得两点观察。其一,优势并不局限于单一线路家族:每个编译套件在几何平均上都快于参照方,从 QASMBench 小线路的 0.140x 到 Feynman 套件的 0.452x。其二,几何平均一致优于平均用时求和之比,说明该优势是广泛分布于各用例的,而非由少数极端用例拉动。
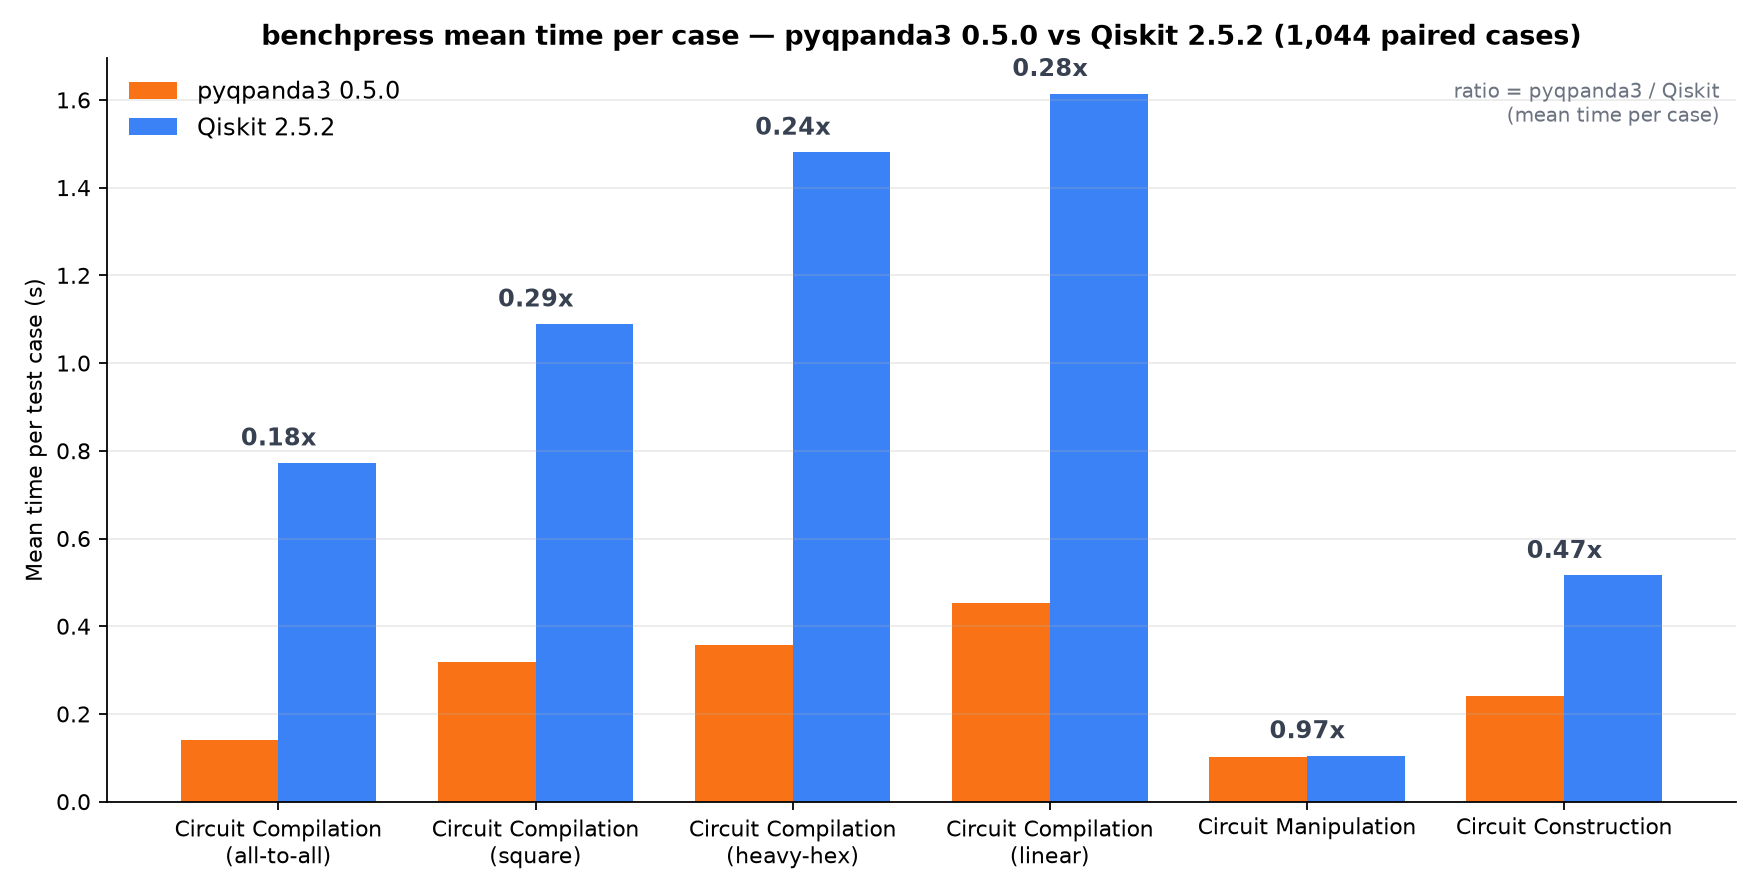
按类别统计的每用例平均用时如图 pyqpanda3 0.5.0 vs Qiskit 2.5.2 —— 每用例平均用时 所示,该图采用平均用时求和之比的基准绘制。
对耦合图拓扑的依赖
892 个抽象编译用例分布在四种耦合图上。在图中采用的平均用时求和之比基准下,pyqpanda3 0.5.0 完成配对用例的用时分别为 Qiskit 2.5.2 的 0.18x(all-to-all)、0.24x(heavy-hex)、0.28x(square)与 0.29x(linear)。在几何平均基准下,同样这四种拓扑族分别读作 0.12x、0.24x、0.25x 与 0.27x。
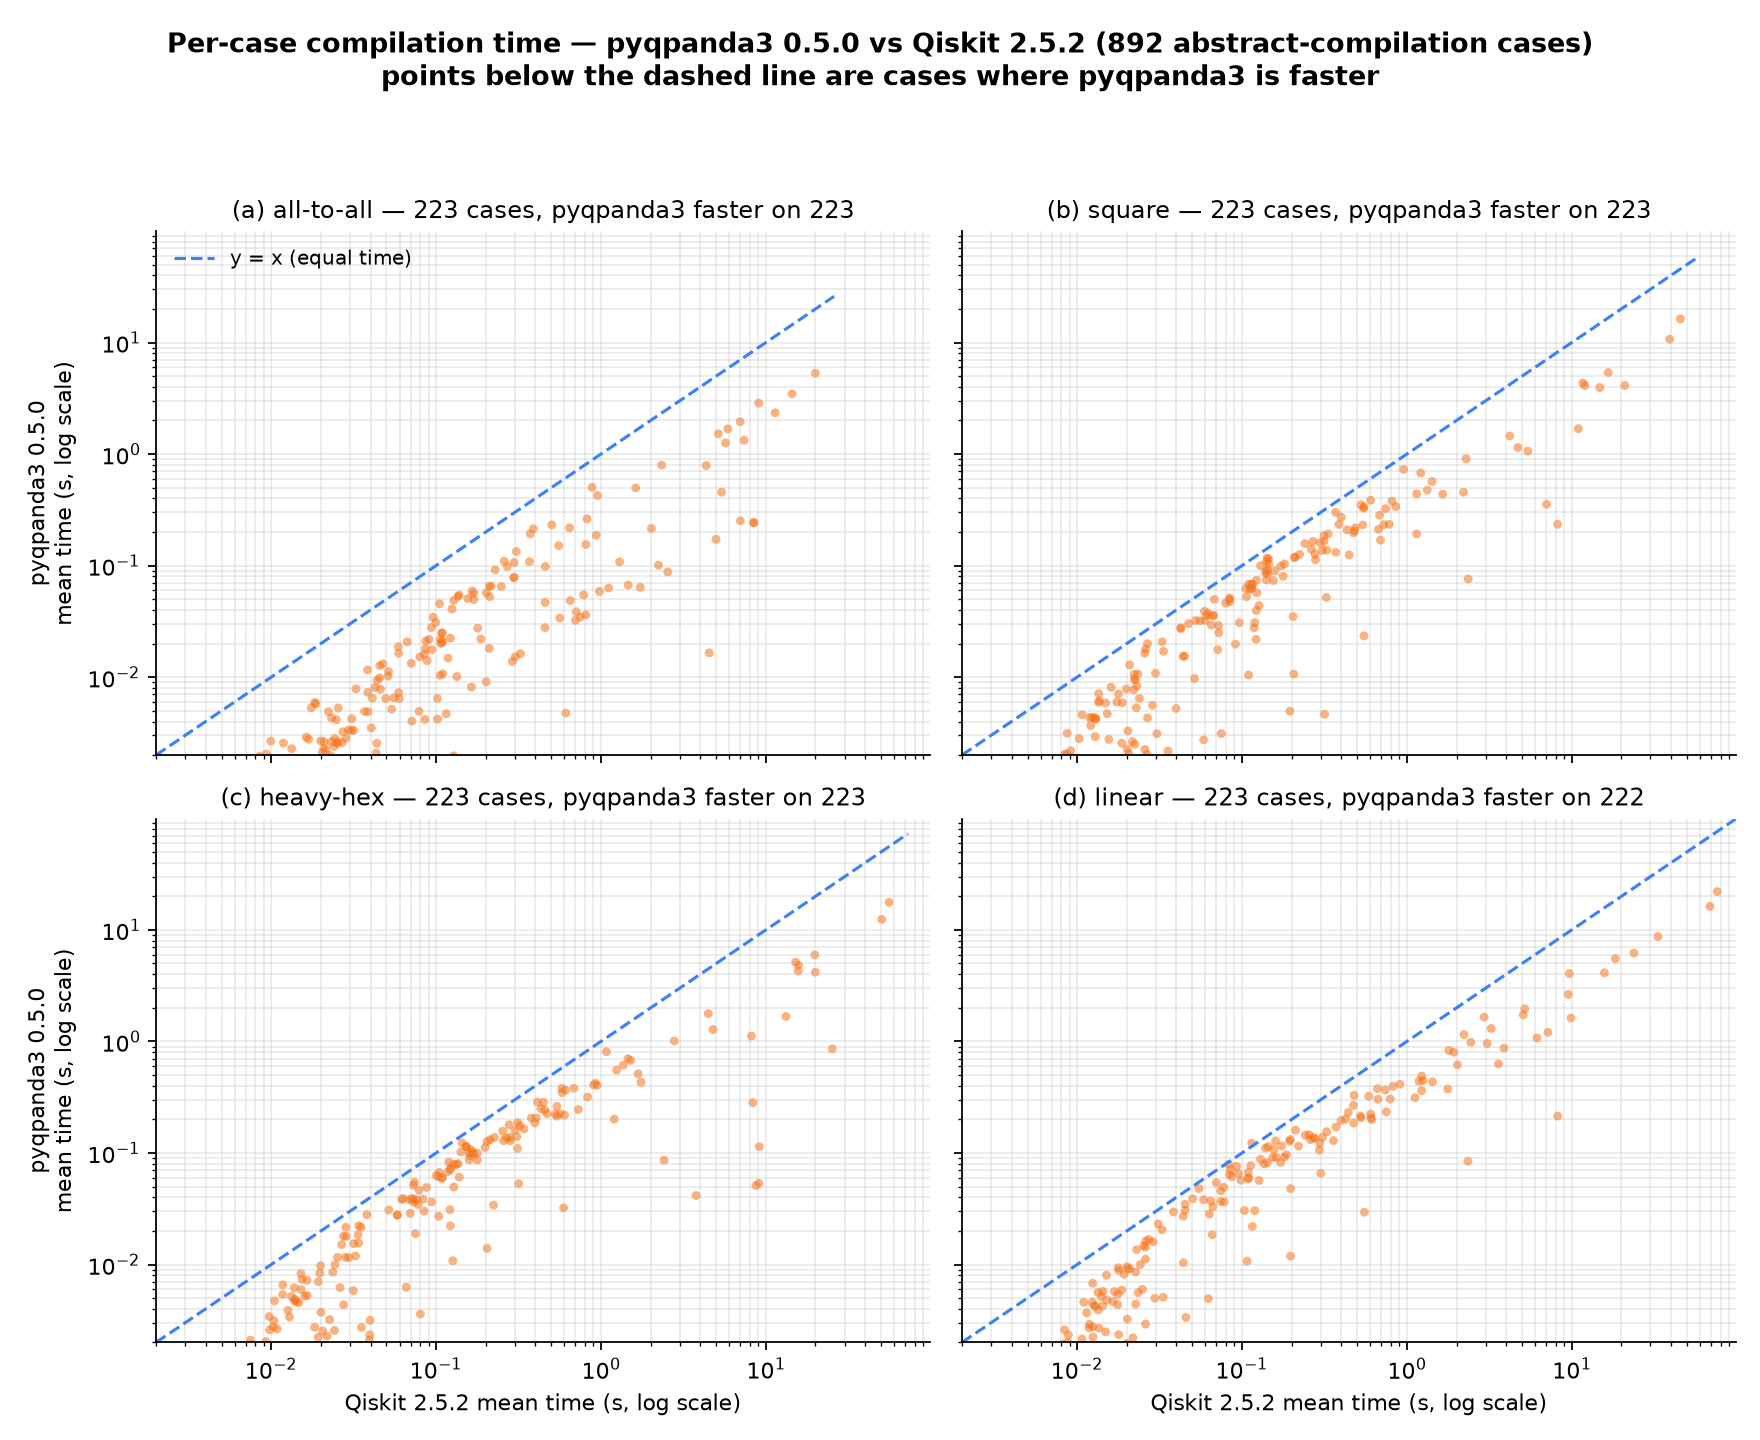
all-to-all 图在两种基准下均显示出最大优势,且该族中 223 个用例全部更快。三种稀疏图则彼此聚集在一条狭窄区间内。值得注意的是,优势并未随耦合图约束变紧而衰减:linear 与 square 是该集合中约束最强的两种图,二者仍远低于持平线。
图 pyqpanda3 0.5.0 vs Qiskit 2.5.2 —— 逐用例编译用时 以对数坐标逐用例对比了两个 SDK 在 892 个抽象编译用例上的编译用时,每种拓扑一张子图;虚线下方的点表示 pyqpanda3 更快的用例。可以观察到,四张子图中的散点几乎全部位于虚线下方(892 例中的 891 例),且该优势不局限于特定拓扑或特定线路家族。
逐用例比值的分布
上述聚合指标刻画的是集中趋势,而分布刻画的是稳定性。在 1,044 个配对用例上,逐用例时间比落入以下区间:
| 比值区间(pyqpanda3 / Qiskit) | 用例数 |
|---|---|
| 低于 0.10x | 231 |
| 0.10x – 0.25x | 214 |
| 0.25x – 0.50x | 317 |
| 0.50x – 0.75x | 247 |
| 0.75x – 1.00x | 31 |
| 1.00x 及以上 | 4 |
分位数分别为 p10 = 0.056、p25 = 0.112、中位数 = 0.310、p75 = 0.525、p90 = 0.629。相当一部分用例——1,044 例中的 445 例,约 43%——在参照方用时的四分之一以内完成;1,044 例中的 1,009 例(96.6%)低于 0.75x。仅 4 例达到或超过持平线。
在 1,032 个编译用例中,恰好只有一例超过持平线,为 1.07x(ham_fh-graph-1D-grid-nonpbc-qubitnodes_Lx-90)。以编译用时超过 10 秒的用例数计,pyqpanda3 为 6 例,参照方为 28 例;被测方最慢的单个用例耗时 22.0 秒,而对应的参照方用例为 76.3 秒。
输出质量
只有在产出的线路仍具可比性时,速度才有意义,因此本节直接对比了转译输出。在全套件上求和,pyqpanda3 0.5.0 输出线路的双量子比特门数为 Qiskit 2.5.2 的 0.957x;在 892 个抽象编译用例上,双量子比特深度合计为 0.918x。速度优势总体上并未以线路质量为代价。
在设备定向用例上,被测方在两项指标上均领先(门数 0.921x,深度 0.883x);在抽象用例上,被测方在深度上领先(0.918x),门数持平(0.960x)。分到各套件后,情况更为细致:在哈密顿量族上被测方产出的双量子比特门显著更少(抽象 0.834x,设备 0.776x),线路也相应更浅;而在 Summit 100Q 与 Feynman 族上则略多(1.049x 与 1.013x)——以几个百分点的差异换取了上文报告的用时缩减。
在双方均报告双量子比特门数的 1,035 个用例中,pyqpanda3 0.5.0 在 277 例上产出更少的双量子比特门,410 例数量完全相同,348 例更多。因此该分布并非单向:总体 0.957x 是大量改进与退化共同作用的净结果,并以缩减幅度最大的哈密顿量族为主导。
参照方用时更短的用例
1,044 个用例中有 4 例由 Qiskit 2.5.2 取得。四例均限于毫秒量级的操作,且没有任何一例超过 1.6x:
| 用例 | 分组 | 比值 | pyqpanda3 | Qiskit 2.5.2 |
|---|---|---|---|---|
test_QV100_build | 线路构造 | 1.58x | 6.43 ms | 4.08 ms |
test_multi_control_decompose | 线路操作 | 1.29x | 17.35 ms | 13.42 ms |
test_param_circSU2_100_build | 线路构造 | 1.28x | 2.06 ms | 1.61 ms |
ham_fh-graph-1D-grid-nonpbc-qubitnodes_Lx-90 | 抽象哈密顿量编译 | 1.07x | 122.5 ms | 114.6 ms |
四例中有三例属于构造与操作分组,而这两个分组在 1,044 个用例中合计仅占 12 例;承载 1,032 个用例的各编译分组只贡献了一条略高于持平线的记录。