
pyqpanda3 0.4.1 让保真度数据真正驱动转译决策,并补齐了模拟器版图。v0.5.0 回答下一个问题:当工作流已经正确时,它还能多快、多省?
答案贯穿整个技术栈——每个模拟器都可选择的算术精度、进程启动即选定的 SIMD 内核、重建的布局/路由引擎,以及随包分发的内存分配器。本版本的主题是"把性能的旋钮暴露出来"。
精度从此是一种选择,而不是意外
每个 CPU 系列模拟器在构造时接受 precision 关键字:float32 将状态内存减半、内核吞吐大致翻倍;float64 保持默认。该选择在每个实例上不可变且可读回,下游代码可以据此适配:
import numpy as np
from pyqpanda3.core import CPUQVM, MPSQVM, H, CNOT, QProg

seed = np.array([0.5, 0.5, 0.5, 0.5], dtype=np.complex64)

qvm32 = CPUQVM(precision="float32")
qvm32.init_state(seed)
print(qvm32.current_state().dtype, qvm32.current_state().shape, qvm32.precision)

qvm64 = CPUQVM()
qvm64.init_state(seed)
print(qvm64.current_state().dtype, qvm64.current_state().shape, qvm64.precision)

mps = MPSQVM(precision="float32")
mps.run(QProg() << H(0) << CNOT(0, 1), 2)
print(mps.current_state().dtype, mps.current_state().shape)
运行结果:
complex64 (4,) float32
complex128 (4,) float64
complex64 (4,)
current_state() 是新方法——以 NumPy 数组返回模拟器原生精度的状态,DensityMatrixSimulator.density_matrix_native() 对密度矩阵做同样的事。读回时有一点必须区分:CPUQVM.current_state() 镜像的是经 init_state(...) 装入的状态,不会被 run() 填充——run() 产生的状态请用 result().get_state_vector() 读取;而 MPSQVM.current_state() 就是 run() 之后的实时状态。精度写错会立刻以专属异常失败(InvalidPrecisionError、UnsupportedPrecisionError),绝不静默。
哪个后端支持什么?问注册表,不用猜:
from pyqpanda3.core import simulator_capabilities

for cap in simulator_capabilities():
    print(f"{cap.name:26s} {','.join(cap.supported_precisions):16s}"
          f" available={str(cap.available):5s} domain={cap.simd_domain}")
运行结果:
CPUQVM                     float32,float64  available=True  domain=StateVector
DensityMatrixSimulator     float32,float64  available=True  domain=Density
GPUQVM                     float64          available=False domain=NotApplicable
MPSQVM                     float32,float64  available=True  domain=Tensor
PartialAmplitudeQVM        float32,float64  available=True  domain=Amplitude
SingleAmplitudeQVM         float32,float64  available=True  domain=Amplitude
SparseHeisenbergSimulator  float32,float64  available=True  domain=Sparse
Stabilizer                 exact            available=True  domain=NotApplicable
那行 GPUQVM … available=False 正是注册表在无 CUDA 主机上的价值所在:构造会在最前面被 BackendUnavailableError 拒绝,而不是在导入时含糊地失败。
运行时选定的 SIMD 内核
态矢量内核现在为多种 SIMD 指令集编译,并在进程启动时由探测器选定。新的 pyqpanda3.core.simd 子模块展示这个决定,也允许你覆盖它:
from pyqpanda3.core import simd

cap = simd.capabilities()
print(cap.architecture, list(cap.available_backends), cap.active_backend)

simd.set_preference("scalar")  # 复现传统标量行为
print(simd.active_backend())
simd.set_preference("auto")
print(simd.active_backend())
运行结果(在支持 AVX2 的 x86_64 主机上):
x86_64 ['scalar', 'sse2', 'avx2', 'avx512'] avx2
scalar
avx2
在发布基准主机上,AVX2 内核在代表性套件上比标量快中位 2.13x(float32 约 2.5x,float64 约 1.9x)。提升策略刻意保守:只有当某后端的正确性行全部通过且实测运行时间优于下一个安全后端时,它才会成为自动选择——AVX-512 与 NEON 始终可以显式选择,但绝不在没有验证证据的情况下被静默自动提升。
重建的 LightSABRE 引擎
布局与路由围绕共享的 LightSABRE 引擎重建:带均衡布局-路由目标函数的双向 SABRE 布局搜索、面向可嵌入子图的 VF2 补全、环形邻域候选,以及针对病态实例的工作量熔断器。Python API 保持不变——还是那些 TranspilationOptions、那个 RoutingMethod.LIGHT_SABRE——但结果变了:
- 在 benchpress 套件上,与 Qiskit 2.5.2 的 1,044 个配对用例(双方全部通过 1,044 例)中,pyqpanda3 0.5.0 在 1,040 / 1,044 例上更快,几何平均时间比 0.233x;
- 输出质量同样立得住:全套件双量子比特门总数为 Qiskit 的 0.957x,892 个抽象编译用例的双量子比特深度为 0.918x;
- pyqpanda3 仅 6 个编译用例超过 10 秒,参照方为 28 个。
确定性是显式的:固定 TranspilationExecutionConfig.seed 后同一程序的重复转译完全一致,且该配置现在也可以作为 transpile() 的最后一个位置参数传入。
与 0.4.1 的实测对比
为量化本版本的变化,两个 wheel 在同一主机、同一解释器(CPython 3.14)上以相同的种子化负载并行对比:随机长程 19 比特线路在三种固定耦合图(线性链、5x5 网格、与 benchpress 相同生成器产出的 heavy-hex 补丁)上的转译、QV100 规模的 OpenQASM 导入、5 控制 X 向 CZ 基的综合,以及随机 4 比特酉 Oracle 循环。报告时间为五轮交叉运行的最小值——共享主机上的调度噪声只会让更快的一方吃亏,不会反过来。
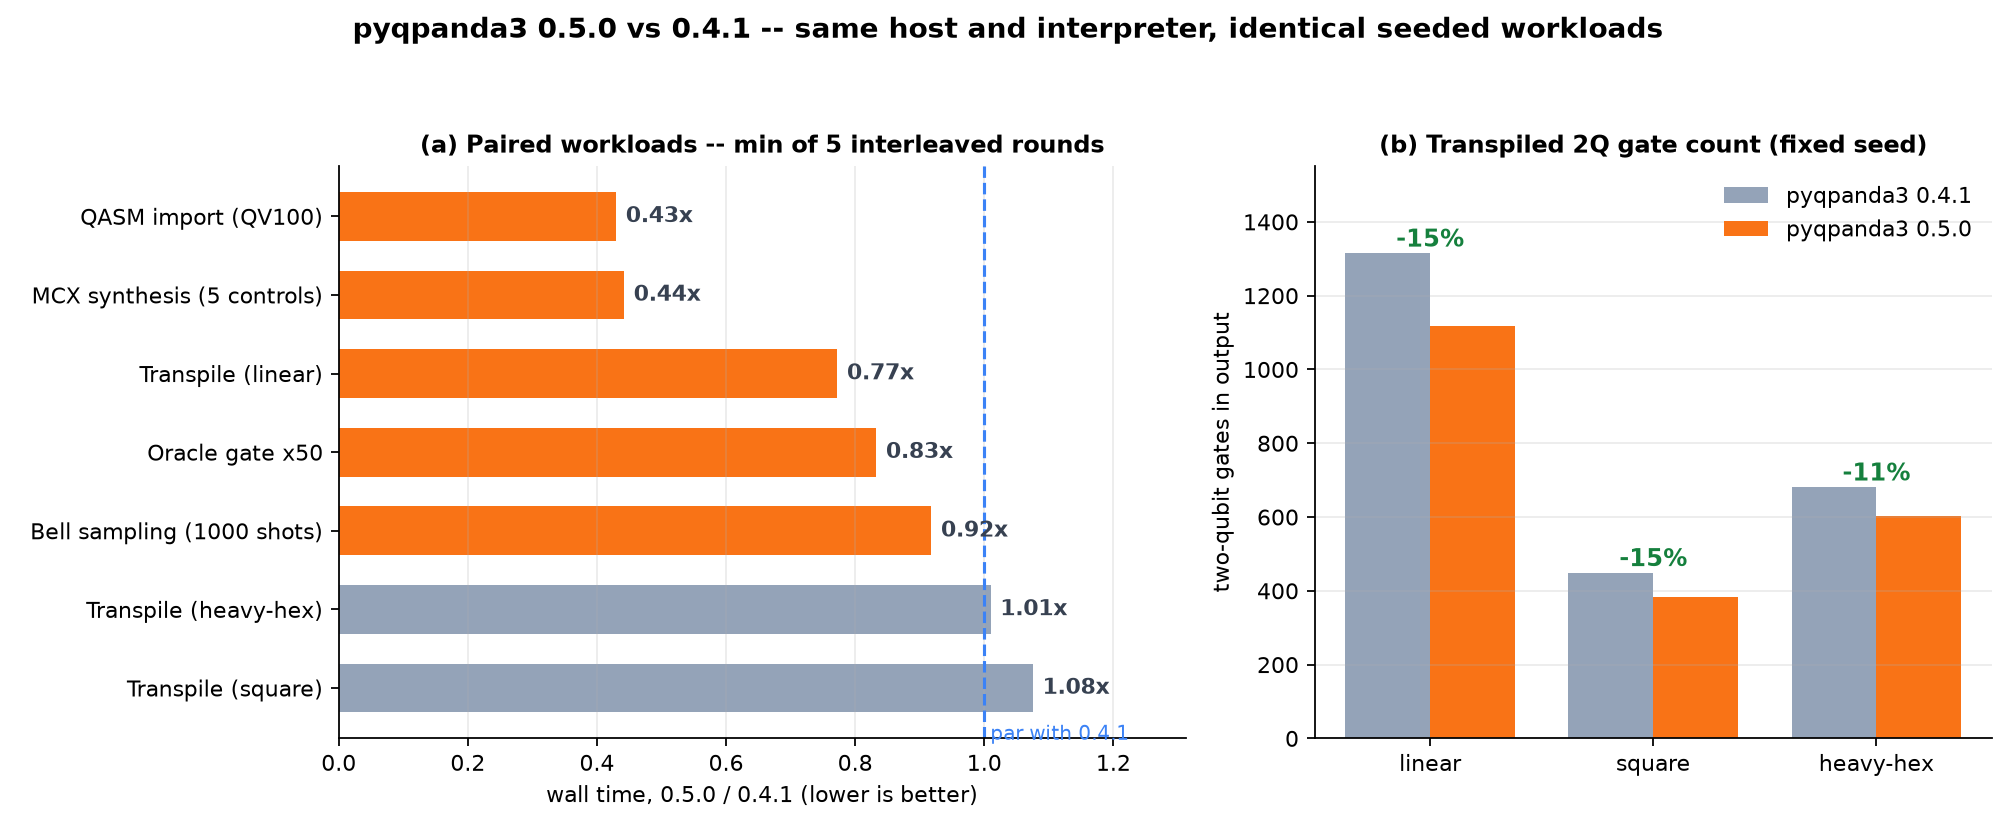
内核级的变化直接体现在数字上:QASM 导入快速通道的吞吐翻倍以上(为 0.4.1 用时的 0.43x),MCX 综合以 0.44x 的用时输出完全相同的 248 个 CZ 门,长程线路到线性链的转译用时为 0.77x。在方形与 heavy-hex 耦合图上转译用时与 0.4.1 持平——但转译产物严格更优:种子固定时,输出的双量子比特门数在三种拓扑下分别下降 15%(线性)、15%(方形)与 11%(heavy-hex)。这正是 LightSABRE 重写的价值所在:编译时间相当或更好,输出线路可度量地更好。
态矢量模拟方面,float64 演化与 0.4.1 性能相当;提速来自新的 float32 路径(状态内存约减半,并喂给 SIMD 内核)——在发布基准套件上,AVX2 内核相对标量的中位加速为 2.13x。
原生 RESET
RESET(qubit) 作为一等操作将量子比特坍缩到 |0>——measure 加条件 X 的组合舞步可以退场了:
from pyqpanda3.core import CPUQVM, QProg, RESET, X, measure

prog = QProg() << X(0) << RESET(0) << measure(0, 0)
qvm = CPUQVM()
qvm.run(prog, 100)
print(qvm.result().get_counts())
运行结果:
{'0': 100}它可经 OriginIR 双向往返,并可从 OpenQASM 的 reset 语句解析。(0.5.0 不支持把 RESET 导出回 OpenQASM——序列化请使用 OriginIR。)
其他值得注意的变化
- MPS 截断旋钮:
MPSQVM(truncation_atol=..., max_bond_dimension=...)加上报告discarded_weight与实际最大键维的stats()——现在可以刻意用精度换内存,并证明代价是什么。 - 噪声语义显式化:行主序 Kraus 矩阵、按
M[true][measured]索引的ReadoutError、噪声作用于指令之后、局部误差覆盖默认——由针对两个库运行的测试套件验证。NoiseModel也补上了真正的copy()/deepcopy()。 - 云端易用性:
QCloudOptions.get_custom_option()现在返回存储值的真实类型——此前按类型的重载坍缩为单一 Python 签名,只有int可达。 - 其他内核提速:ORACLE 门路径采用零拷贝矩阵与手写 AVX2 GEMM;QV100 规模 QASM 文件导入从 1.48s 降至 0.73s
- wheel 中的 mimalloc:wheel 现为平台专属,并捆绑 mimalloc 分配器,使大规模状态的性能更稳定。
完整的 API 变更清单见 v0.5.0 发布说明,完整的 benchpress 分析见基准测试页面。