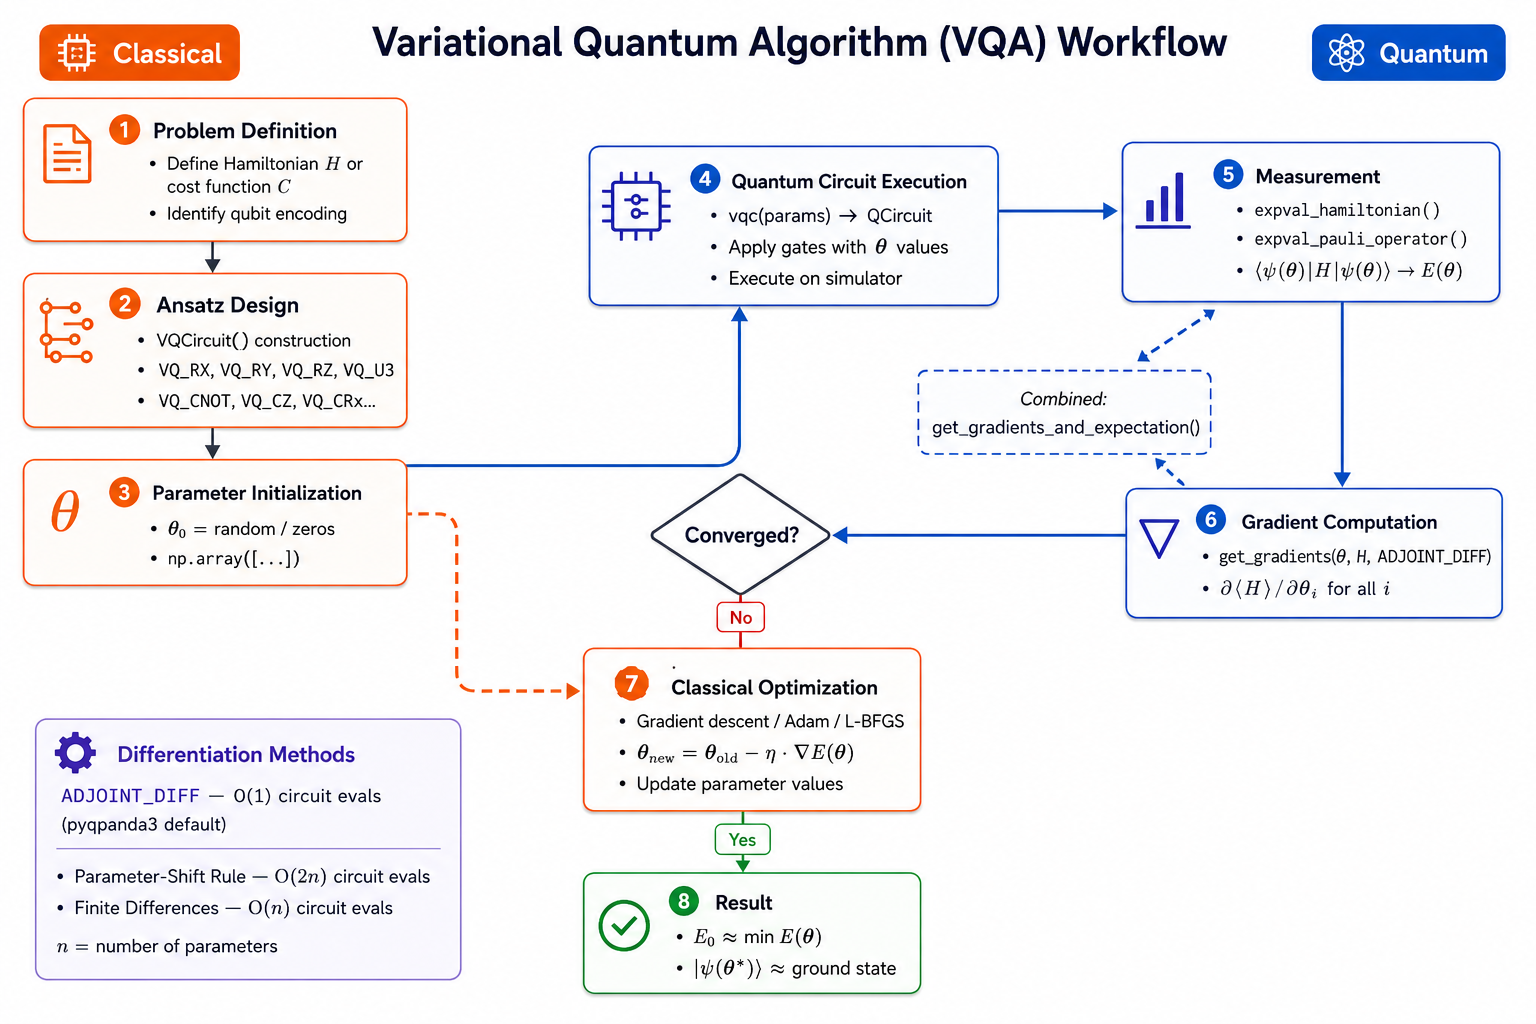
变分量子算法
变分量子算法理论,包括变分原理、VQE、QAOA、贫瘠高原和梯度计算方法。本指南将理论基础与 pyqpanda3 的变分量子线路(VQC)框架联系起来。
变分原理
Rayleigh-Ritz 变分原理
所有变分量子算法的基础是 Rayleigh-Ritz 变分原理:
对于任何参数化量子态
和任何哈密顿量 ,能量的期望值提供了基态能量 的上界:
当且仅当
能量作为代价函数
变分原理允许我们将基态问题表述为优化问题:
损失函数(能量)为:
这个损失函数具有重要性质:
- 非负曲率:
- 平滑性:对于解析拟设,
是 的平滑函数 - 可观测性:
可以从量子测量中估计
变分量子线路作为尝试态
在 pyqpanda3 中,尝试态
其中
VQC 使用 pyqpanda3 的 VQCircuit 类构建:
from pyqpanda3.vqcircuit import VQCircuit
from pyqpanda3.core import RY, CNOT

# 构建硬件高效拟设
# set_Param 初始化线路的参数数组维度
vqc = VQCircuit()
vqc.set_Param([4])
vqc << RY(0, vqc.Param([0], "theta_0"))
vqc << RY(1, vqc.Param([1], "theta_1"))
vqc << CNOT(0, 1)
vqc << RY(0, vqc.Param([2], "theta_2"))
vqc << RY(1, vqc.Param([3], "theta_3"))
表达能力
VQC 的表达能力(Expressibility) 衡量其探索希尔伯特空间的能力。完美表达的拟设生成 Haar 均匀的幺正分布。表达能力较弱的拟设可能无法达到最优解。
表达能力通过偏离 Haar 分布的程度来衡量:
设计良好的拟设在表达能力与可训练性之间取得平衡(避免贫瘠高原)。
VQE — 变分量子特征值求解器
算法概述
变分量子特征值求解器(Variational Quantum Eigensolver, VQE)是一种用于寻找哈密顿量基态能量的混合量子-经典算法:
graph TD
    Start["定义哈密顿量 H"] --> Ansatz["选择拟设 VQCircuit"]
    Ansatz --> Init["初始化 θ"]
    Init --> Quantum["制备 |ψ(θ)⟩<br/>测量 ⟨H⟩"]
    Quantum --> Classical["经典优化器<br/>更新 θ"]
    Classical --> Converge{"收敛?"}
    Converge -->|否| Quantum
    Converge -->|是| Result["E₀ ≈ min ⟨H⟩"]

    style Quantum fill:#e3f2fd,stroke:#1565c0
    style Classical fill:#fff3e0,stroke:#e65100
    style Result fill:#c8e6c9,stroke:#2e7d32
哈密顿量分解
为了在量子计算机上测量能量,哈密顿量必须分解为可测量的 Pauli 字符串:
其中
能量期望值则为:
每个
pyqpanda3 提供:
pyqpanda3.core.expval_hamiltonian(prog, hamiltonian, shots=1, model=..., used_threads=4, backend='CPU')— 从量子程序直接计算期望值pyqpanda3.core.expval_pauli_operator(prog, pauli_operator, shots=1, model=..., used_threads=4, backend='CPU')— Pauli 算符期望值
拟设设计策略
硬件高效拟设(Hardware-Efficient Ansatz):
设计为匹配目标硬件的原生门集和连接性:
其中 ENTANGLE 是匹配硬件拓扑的 CNOT 门层。
- 优点:浅深度、原生门、较少 SWAP 开销
- 缺点:可能需要多层,容易陷入贫瘠高原
化学启发拟设(幺正耦合簇):
基于幺正耦合簇单双激发(UCCSD):
其中
- 优点:物理动机明确、小分子参数少
- 缺点:线路深、需要 Trotter 化
自适应拟设(ADAPT-VQE):
通过添加具有最大梯度的算符来迭代增长拟设:
其中
- 优点:紧凑拟设、系统化构建
- 缺点:每步需要梯度池评估
经典优化
经典优化器更新参数以最小化能量:
VQE 中常用的优化器:
| 优化器 | 类型 | 优点 | 缺点 |
|---|---|---|---|
| 梯度下降 | 一阶 | 简单、稳定 | 收敛慢 |
| Adam | 一阶(自适应) | 快速、鲁棒 | 可能振荡 |
| L-BFGS-B | 拟牛顿 | 超线性收敛 | 对噪声梯度敏感 |
| COBYLA | 无导数 | 可处理噪声 | 参数多时慢 |
| SPSA | 随机 | 抗噪声、每步 | 收敛慢 |
| SNOBFIT | 代理模型 | 适合噪声景观 | 每次迭代代价高 |
测量噪声与统计误差
能量估计具有来自有限测量次数的统计不确定性:
其中
经验法则:精度翻倍需要
收敛性分析
VQE 收敛取决于:
- 拟设质量:拟设能否到达基态?
- 优化器效率:优化器多快找到最小值?
- 噪声抗性:噪声对能量估计的影响有多大?
VQE 通常被认为是噪声抗性的,因为:
- 变分原理仍然成立(含噪声的能量仍然是上界)
- 优化器可以部分补偿系统性噪声
- 测量噪声的误差条可以指导优化器
QAOA — 量子近似优化算法
算法概述
QAOA 专为组合优化问题设计。给定比特串
其中:
是代价哈密顿量(在计算基中是对角的) 是混合哈密顿量(Mixer Hamiltonian) 和 是变分参数 是 QAOA 深度(交替层数)
graph LR
    Plus["|+⟩^⊗n"] --> L1["e^{-iγ₁H_C}"]
    L1 --> M1["e^{-iβ₁H_M}"]
    M1 --> L2["e^{-iγ₂H_C}"]
    L2 --> M2["e^{-iβ₂H_M}"]
    M2 --> Dot["..."]
    Dot --> LP["e^{-iγ_P H_C}"]
    LP --> MP["e^{-iβ_P H_M}"]
    MP --> Measure["测量<br/>⟨H_C⟩"]

    style L1 fill:#f8cecc,stroke:#b85450
    style L2 fill:#f8cecc,stroke:#b85450
    style LP fill:#f8cecc,stroke:#b85450
    style M1 fill:#dae8fc,stroke:#6c8ebf
    style M2 fill:#dae8fc,stroke:#6c8ebf
    style MP fill:#dae8fc,stroke:#6c8ebf
MaxCut 示例
QAOA 的典型应用是 MaxCut。给定图
代价哈密顿量:
这为 Z 值不同的顶点的边分配能量
混合哈密顿量:
QAOA 线路构建:
每个代价层
每个混合层
近似比
近似比衡量 QAOA 的质量:
:对于 3-正则图上的 MaxCut, (由 QAOA 理论保证) : (QAOA 收敛到最优) - 在实践中,
到 通常可实现
QAOA 变体
| 变体 | 描述 | 优势 |
|---|---|---|
| 标准 QAOA | 固定深度 | 理论保证 |
| 热启动 QAOA | 从经典解初始化 | 更好的初始点 |
| 递归 QAOA | 迭代固定量子比特 | 减小问题规模 |
| 多角度 QAOA | 每个门不同角度 | 更具表达力 |
| 带约束的 QAOA | 处理约束问题 |
贫瘠高原
梯度消失问题
贫瘠高原(Barren Plateaus) 在代价函数的梯度随量子比特数量指数级消失时出现:
这意味着对于
graph TD
    Shallow["浅线路<br/>(少量参数)"] --> Trainable["可训练景观<br/>大梯度"]
    Deep["深线路<br/>(大量参数)"] --> Barren["贫瘠高原<br/>指数级小梯度"]

    Expressible["高表达能力"] --> Barren
    Entangled["高纠缠"] --> Barren
    Noise["硬件噪声"] --> Barren

    Local["局部代价函数"] --> Avoid["避免贫瘠高原"]
    Structured["结构化拟设"] --> Avoid
    Parameters["精心初始化"] --> Avoid

    style Trainable fill:#c8e6c9,stroke:#2e7d32
    style Barren fill:#ffebee,stroke:#c62828
    style Avoid fill:#e3f2fd,stroke:#1565c0
贫瘠高原的成因
1. 表达能力引起的:高表达能力的拟设覆盖整个希尔伯特空间,倾向于将代价函数值集中在均值附近,使景观平坦化。
2. 纠缠引起的:深度纠缠线路产生全局态,其中局部参数变化的影响呈指数级减小。
3. 噪声引起的:硬件噪声通过将所有输出驱动到最大混合态来平坦化代价景观。
4. 全局代价函数:依赖所有量子比特的代价函数(如全局保真度)即使对于浅线路也会出现贫瘠高原。
缓解策略
1. 局部代价函数:
将全局代价函数替换为局部代价函数:
局部代价函数的梯度以多项式而非指数形式消失。
2. 结构化拟设:
使用内置结构的拟设(如保对称性、受问题启发的):
- 组合优化的 QAOA 拟设
- 化学的 UCCSD 拟设
- 有限深度的硬件高效拟设
3. 参数初始化:
- 恒等初始化:从接近恒等线路的参数开始(
) - 逐层训练:一次训练一层,逐步添加层
- 经典预训练:使用经典优化找到好的初始点
4. 梯度保持架构:
- 使用梯度大小可证明有下界的线路
- 例如:量子卷积神经网络(QCNN)、某些层次化线路
梯度计算方法
概述
计算期望值
graph TD
    Grad["梯度方法"] --> PS["参数平移规则"]
    Grad --> AD["伴随微分"]
    Grad --> FD["有限差分"]
    Grad --> LS["幺正线性组合"]

    PS -->|"每个参数 2 次线路评估"| Exact1["精确梯度"]
    AD -->|"总共 2 次线路评估"| Exact2["精确梯度"]
    FD -->|"每个参数 2 次线路评估"| Approx["近似梯度"]
    LS -->|"O(1) 次线路评估"| Exact3["精确(需辅助比特)"]

    style Exact1 fill:#c8e6c9,stroke:#2e7d32
    style Exact2 fill:#c8e6c9,stroke:#2e7d32
    style Exact3 fill:#c8e6c9,stroke:#2e7d32
    style Approx fill:#fff3e0,stroke:#e65100
参数平移规则
参数平移规则通过每个参数两次线路评估提供精确梯度:
其中
对于特征值为
开销:
优势:
- 精确梯度(无近似误差)
- 硬件兼容(只需前向评估)
- 可与测量噪声配合使用(仅有统计误差)
伴随微分
伴随微分以 ADJOINT_DIFF 使用的方法:
其中
算法(Jones & Gacon, 2020):
- 前向传播:计算
- 反向传播:逆序施加门,计算内积
- 总计:无论参数数量多少,只需 2 次线路评估(一次前向,一次反向)
开销:总共 2 次线路评估。
优势:
- 对于大参数量显著加速:
相比 - 精确梯度
- 非常适合基于仿真的优化
限制:
- 需要存储中间态矢量(内存:
) - 仅适用于态矢量仿真,不适用于硬件测量
- 依赖于模拟器的实现
在 pyqpanda3 中的使用:
from pyqpanda3.vqcircuit import VQCircuit, DiffMethod
from pyqpanda3.hamiltonian import Hamiltonian
from pyqpanda3.core import RY, CNOT
import numpy as np

# 构建一个包含 4 个参数的简单拟设
vqc = VQCircuit()
vqc.set_Param([4])
vqc << RY(0, vqc.Param([0], "theta_0"))
vqc << RY(1, vqc.Param([1], "theta_1"))
vqc << CNOT(0, 1)
vqc << RY(0, vqc.Param([2], "theta_2"))
vqc << RY(1, vqc.Param([3], "theta_3"))

params = np.array([0.1, 0.2, 0.3, 0.4])
observable = Hamiltonian({"Z0 Z1": 1.0, "X0": 0.5})

# 使用伴随微分获取梯度
gradients = vqc.get_gradients(params, observable, DiffMethod.ADJOINT_DIFF)
# → ResGradients 对象,包含全部 4 个参数的梯度

# 同时获取梯度和期望值
result = vqc.get_gradients_and_expectation(params, observable, DiffMethod.ADJOINT_DIFF)
expectation = result.expectation_val()
# → expectation ≈ 0.957(随参数变化)
grads = result.gradients()
# → grads ≈ [0.202, -0.491, 0.265, -0.511](随参数变化)
有限差分
最简单的梯度近似:
开销:
缺点:
- 近似误差
- 选择
:太小 → 被噪声主导;太大 → 近似误差 - 由于测量噪声敏感性,不推荐用于量子计算
幺正线性组合(LCU)
使用辅助量子比特的高级方法:
可以通过 Hadamard 测试或迭代 QPE 实现,但需要辅助量子比特和门的受控版本。
方法比较
| 方法 | 线路评估次数 | 精确? | 硬件兼容? | 内存 |
|---|---|---|---|---|
| 参数平移 | 是 | 是 | ||
| 伴随微分(ADJOINT_DIFF) | 2 | 是 | 否(仅仿真) | |
| 有限差分 | 否( | 是 | ||
| LCU | 是 | 是(需辅助比特) |
对于 pyqpanda3 仿真,推荐使用 ADJOINT_DIFF,因为它具有 DiffMethod 枚举仅提供 ADJOINT_DIFF 作为可用的微分方法。
pyqpanda3 中的参数管理
多维参数
pyqpanda3 通过 set_Param() 和 Param() 方法支持多维参数数组:
vqc = VQCircuit()

# 设置参数维度:例如 3 层 × 4 个参数
vqc.set_Param([3, 4], ["layer", "param"])

# 访问特定参数元素
theta_00 = vqc.Param([0, 0], "theta_00")  # 第 0 层,第 0 个参数
theta_12 = vqc.Param([1, 2], "theta_12")  # 第 1 层,第 2 个参数
这对于以下场景很有用:
- 批量优化:同时评估多组参数的梯度
- 结构化拟设:将参数映射到物理结构(如层 × 量子比特)
- 迁移学习:在线路块之间共享参数
批量梯度计算
对于
import numpy as np
from pyqpanda3.vqcircuit import VQCircuit, DiffMethod
from pyqpanda3.hamiltonian import Hamiltonian
from pyqpanda3.core import RY, CNOT

# 构建与上文相同的拟设
vqc = VQCircuit()
vqc.set_Param([4])
vqc << RY(0, vqc.Param([0], "theta_0"))
vqc << RY(1, vqc.Param([1], "theta_1"))
vqc << CNOT(0, 1)
vqc << RY(0, vqc.Param([2], "theta_2"))
vqc << RY(1, vqc.Param([3], "theta_3"))

observable = Hamiltonian({"Z0 Z1": 1.0, "X0": 0.5})

# 单组参数
params_1d = np.array([0.1, 0.2, 0.3, 0.4])
grads = vqc.get_gradients(params_1d, observable, DiffMethod.ADJOINT_DIFF)
# → ResGradients(1 组梯度)

# N 组参数(扁平数组,行优先顺序)
params_flat = np.array([0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8])
N = 2
grads_n = vqc.get_gradients(params_flat, observable, N, DiffMethod.ADJOINT_DIFF)
# → ResNGradients(N 组梯度)
结果类
实践考虑
拟设选择指南
| 问题类型 | 推荐拟设 | 理由 |
|---|---|---|
| 分子基态 | UCCSD / k-UpCCGSD | 化学动机、系统性可改进 |
| 组合优化 | QAOA | 理论保证、结构化 |
| 通用优化 | 硬件高效 | 浅深度、硬件原生 |
| 量子机器学习 | 分层旋转 + 纠缠 | 表达能力、可训练 |
| 动力学模拟 | Trotter 化演化 | 物理动机 |
优化器选择指南
| 场景 | 推荐优化器 |
|---|---|
| 仿真(精确梯度) | L-BFGS-B 配合伴随微分 |
| 含噪声仿真 | Adam 配合学习率调度 |
| 硬件(测量噪声) | SPSA 或参数平移 + Adam |
| 少量参数 | COBYLA(无导数) |
| 大量参数 | Adam 或自然梯度方法 |
性能建议
- 仿真时使用伴随微分:
相比 梯度评估 - 分组 Pauli 测量:对易的 Pauli 字符串可以同时测量
- 使用
get_gradients_and_expectation:在单次调用中计算两者,比分别计算更高效 - 从经典解热启动:从经典可解近似初始化参数
- 监控收敛:同时跟踪能量和梯度范数;当梯度范数低于阈值时停止
另请参阅
- VQCircuit API — 变分量子线路的完整 API
- DiffMethod — 微分方法枚举
- 梯度结果 — ResGradients 及相关类
- 哈密顿量 — 哈密顿量构建
- VQA 工作流图 — 可视化 VQA 优化循环
- 量子门理论 — 门基础知识
- 噪声模型理论 — 变分算法中的噪声